Кэширование снижает стоимость запросов, в которых большая часть запроса повторяется: системный промпт, документы, история диалога.
Токены, прочитанные из кэша, тарифицируются по отдельной сниженной цене.
Это позволяет значительно снизить расходы там, где одно и то же начало запроса отправляется многократно и с небольшими интервалами, например:
- агентные циклы и ассистенты для программирования, которые отправляют запросы с большим объемом повторяющегося контекста каждые несколько секунд;
- длинные диалоги, в которых вся история пересылается с каждым запросом.
Принцип работы и стоимость
Большинство запросов к модели начинаются одинаково: системный промпт, инструкции, история диалога, приложенные документы. Провайдер модели запоминает это начало и при следующем запросе не обрабатывает его заново. Ответ модели при этом не меняется, кэширование влияет только на скорость и стоимость обработки.
Общее число входящих токенов остается прежним, меняется цена, по которой они учитываются. Входящие токены делятся на три вида:
|
Вид токенов |
Описание |
Цена |
|
Обычный вход |
Токены, которые модель обрабатывает впервые |
Полная цена входа |
|
Чтение из кэша |
Начало запроса совпало с недавним запросом |
Обычно 5–20% от цены входа |
|
Запись в кэш |
Первое сохранение начала запроса в кэш. Отдельная цена есть только у моделей Claude и GPT-5.6+ |
125% от цены входа |
Кэш хранится недолго: обычно несколько минут после последнего обращения. При редких запросах кэш успевает очиститься, и следующий запрос обрабатывается как обычный. Точное время хранения зависит от провайдера.
Цена чтения из кэша и записи в кэш зависит от модели. Точные значения можно найти в каталоге моделей в панели управления.
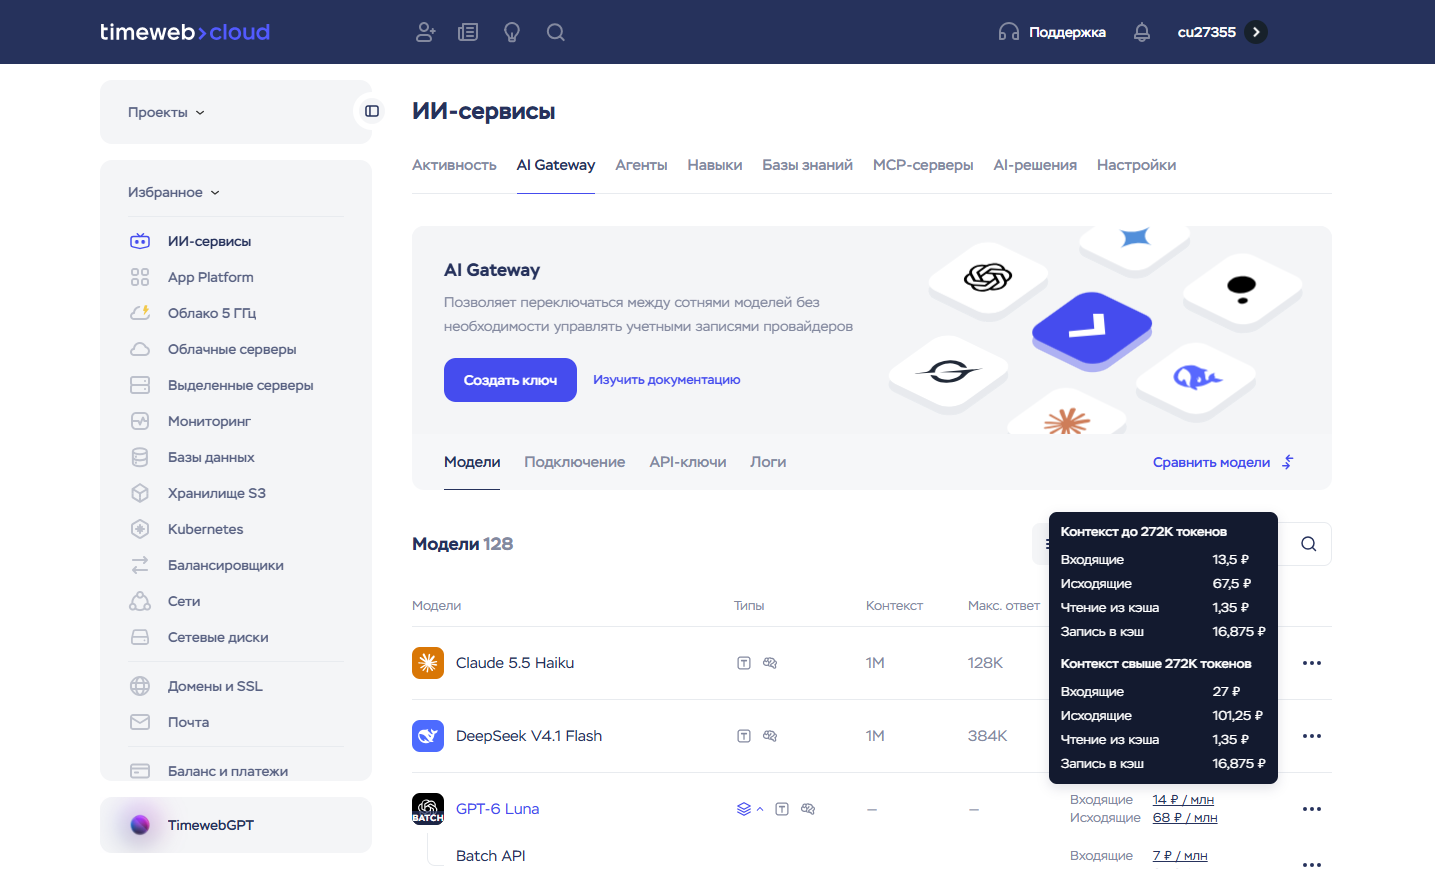
У моделей Claude и GPT-5.6+ первая запись в кэш стоит дороже обычного входа, но выполняется один раз, а чтение из кэша происходит многократно. Поэтому дополнительные затраты на запись окупаются уже со второго запроса с тем же началом. Если запрос отправляется один раз и не повторяется, итоговая стоимость будет немного выше, чем без кэширования.
Если у модели в каталоге нет отдельной цены кэша, все входящие токены считаются по цене входа.
Подключение кэширования
Автоматическое кэширование
Для всех моделей, поддерживающих кэширование, за исключением Claude, кэш работает автоматически: провайдер сам находит повторяющееся начало запроса. Менять запросы не нужно.
Кэширование Claude
При работе с Claude через AI Gateway кэш включается только тогда, когда в запросе есть метка cache_control. Без нее весь входящий объем по моделям Claude тарифицируется по полной цене.
Кэш создается, только если кэшируемая часть запроса не короче минимального размера, который зависит от модели.
Добавьте метку cache_control к последнему блоку той части запроса, которая повторяется от запроса к запросу, например, к системному промпту:
    curl https://api.timeweb.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <ВАШ API-КЛЮЧ>" \
  -d '{
    "model": "anthropic/claude-haiku-5-5",
    "messages": [
      {
        "role": "system",
        "content": [
          {
            "type": "text",
            "text": "<ДЛИННЫЙ_СИСТЕМНЫЙ_ПРОМПТ_ИЛИ_ДОКУМЕНТ>",
            "cache_control": {"type": "ephemeral"}
          }
        ]
      },
      {
        "role": "user",
        "content": "Привет!"
      }
    ]
  }'
Запись в кэш происходит при первом запросе с такой меткой, последующие запросы с тем же началом читают его из кэша.
Чтобы убедиться, что кэш работает, отправьте один и тот же запрос дважды с интервалом не более 5 минут и сравните поле usage в ответах.
В ответе на первый запрос токены записываются в кэш:
    "usage": {
  "prompt_tokens": 724,
  "prompt_tokens_details": {
    "cached_tokens": 0,
    "text_tokens": 24,
    "cache_write_tokens": 700
  },
  "cache_creation_input_tokens": 700,
  "cache_read_input_tokens": 0
}
В ответе на второй запрос те же токены читаются из кэша:
    "usage": {
  "prompt_tokens": 729,
  "prompt_tokens_details": {
    "cached_tokens": 700,
    "text_tokens": 29,
    "cache_write_tokens": 0
  },
  "cache_creation_input_tokens": 0,
  "cache_read_input_tokens": 700
}
Проверка работы кэша
Ответ API содержит поле usage, которое передает провайдер модели.
Значение prompt_tokens включает кэшированные токены.
Количество токенов, прочитанных из кэша, возвращается в prompt_tokens_details.cached_tokens, записанных в кэш — в prompt_tokens_details.cache_write_tokens.
Для моделей Claude те же значения дублируются в полях cache_read_input_tokens и cache_creation_input_tokens.
Если после нескольких запросов с одинаковым началом эти значения остаются нулевыми, кэш не используется.
Вы также можете отслеживать работу кэша в статистике ИИ-сервисов — в разделе «ИИ-сервисы» → «Активность».
Рекомендации по увеличению доли кэша
Чтобы запросы чаще попадали в кэш, размещайте неизменяемую часть (системный промпт, инструкции, документы) в начале запроса, а изменяемую (новый вопрос пользователя) в конце. Любое изменение внутри начала запроса приводит к тому, что кэш для него не применяется.
Особенности и ограничения
Резервирование средств
Резерв средств выполняется по полной цене. Пока запрос не обработан, на балансе замораживается сумма как за обычный вход. При большой доле кэша резерв может в несколько раз превышать итоговое списание, поэтому доступный баланс временно уменьшается, вплоть до отрицательного значения. Через 1–3 часа суммы пересчитываются, лишние средства не списываются.
Минимальная длина промпта
Кэш создается, только если кэшируемая часть запроса не короче минимального размера, который зависит от модели.
Подробности можно найти в документации провайдера, например: OpenAI | Anthropic.
Что не кэшируется
Кэширование недоступно для локальных моделей Timeweb Cloud.
В запросах к остальным моделям веб-поиск, изображения и аудио в кэш не попадают.